知了(Zenow)
知了(Zenow) 是一款本地运行的 AI 知识助手桌面应用,所有数据处理均在本地完成,充分保护您的隐私安全。支持多模型管理、智能对话、知识库问答等功能。
产品特点
- 隐私保护:所有数据本地处理,不上传云端
- 多模型支持:可同时运行 LLM、Embed、Rerank 三类模型
- 知识库问答:基于本地文档进行智能问答
- 多轮对话:保持上下文记忆的连续对话
平台支持
| 平台 & 系统 | 是否支持加速 |
|---|---|
| K1 Buildroot | ❌ 不支持 |
| K1 OpenHarmony | ❌ 不支持 |
| K1 Bianbu LXQT/GNOME | ❌ 不支持 |
| K3 Buildroot | ❌ 不支持 |
| K3 OpenHarmony | ❌ 不支持 |
| K3 Bianbu LXQT/GNOME | ✅ 支持 |
技术架构
核心技术栈
知了基于以下核心技术构建:
-
LLM SDK - 大语言模型推理引擎
- 多轮对话
- 知识库问答
-
前端框架
- Electron - 跨平台桌面应用框架
- React + TypeScript - 用户界面
- Vite - 构建工具
-
后端框架
- FastAPI - 高性能 API 服务
- Python - 运行环境
- SQLite - 本地数据存储
系统架构图
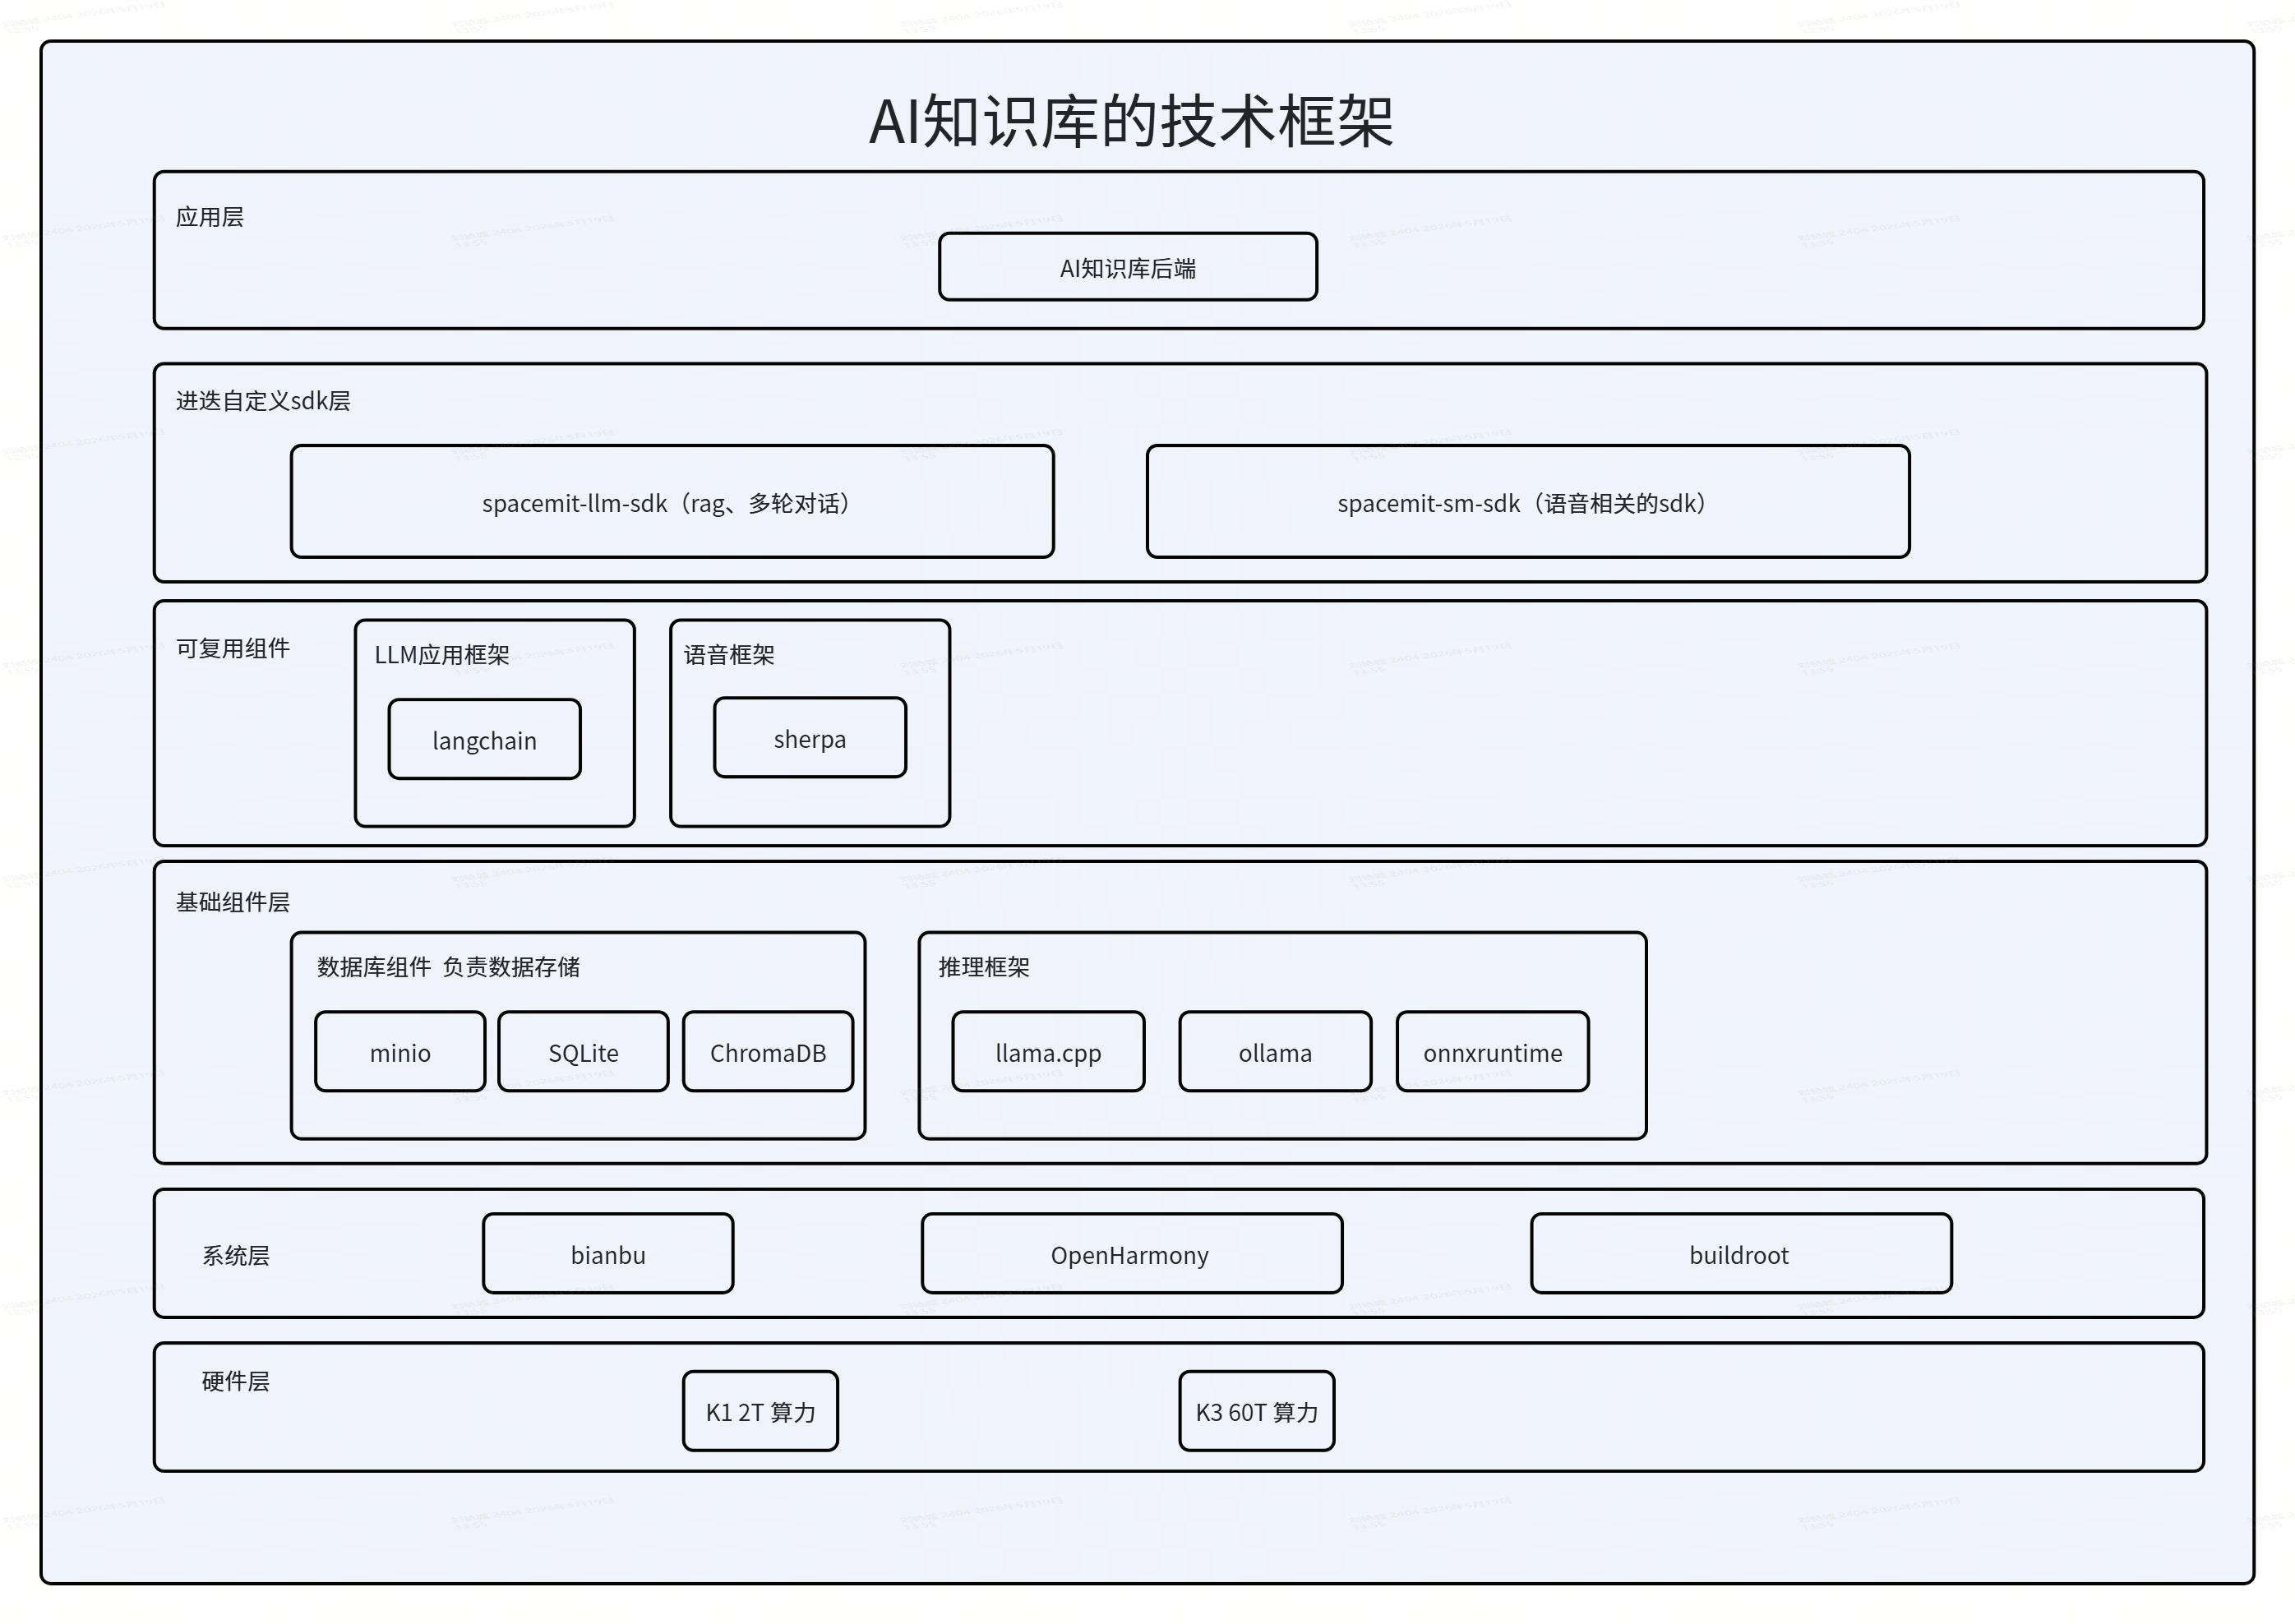
工作流程
- 对话流程:用户输入 → 前端 → 后端会话管理 → LLM Server → 流式返回
- 知识库问答:用户提问 → Embed 初始检索 → 加权融合(Embed + BM25 + Rerank) → LLM 生成答案
安装
在终端中执行以下命令安装知了及其依赖:
sudo apt update
sudo apt install zenow
快速开始
1. 启动应用
点击左下角菜单,搜索 zenow 或 知了,点击启动。
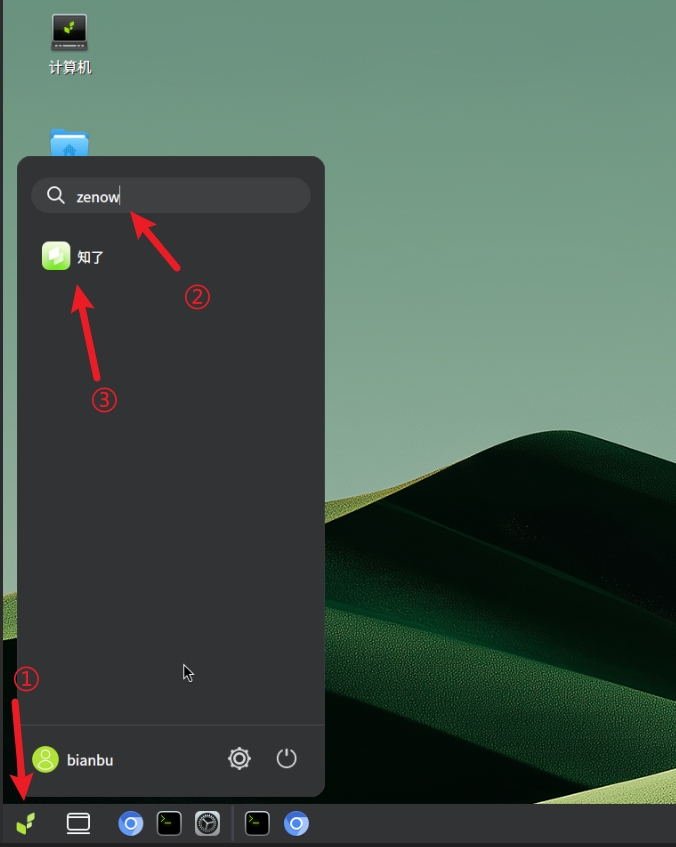
💡 小贴士:右键应用图标选择”添加到桌面”并信任,方便下次快速启动。
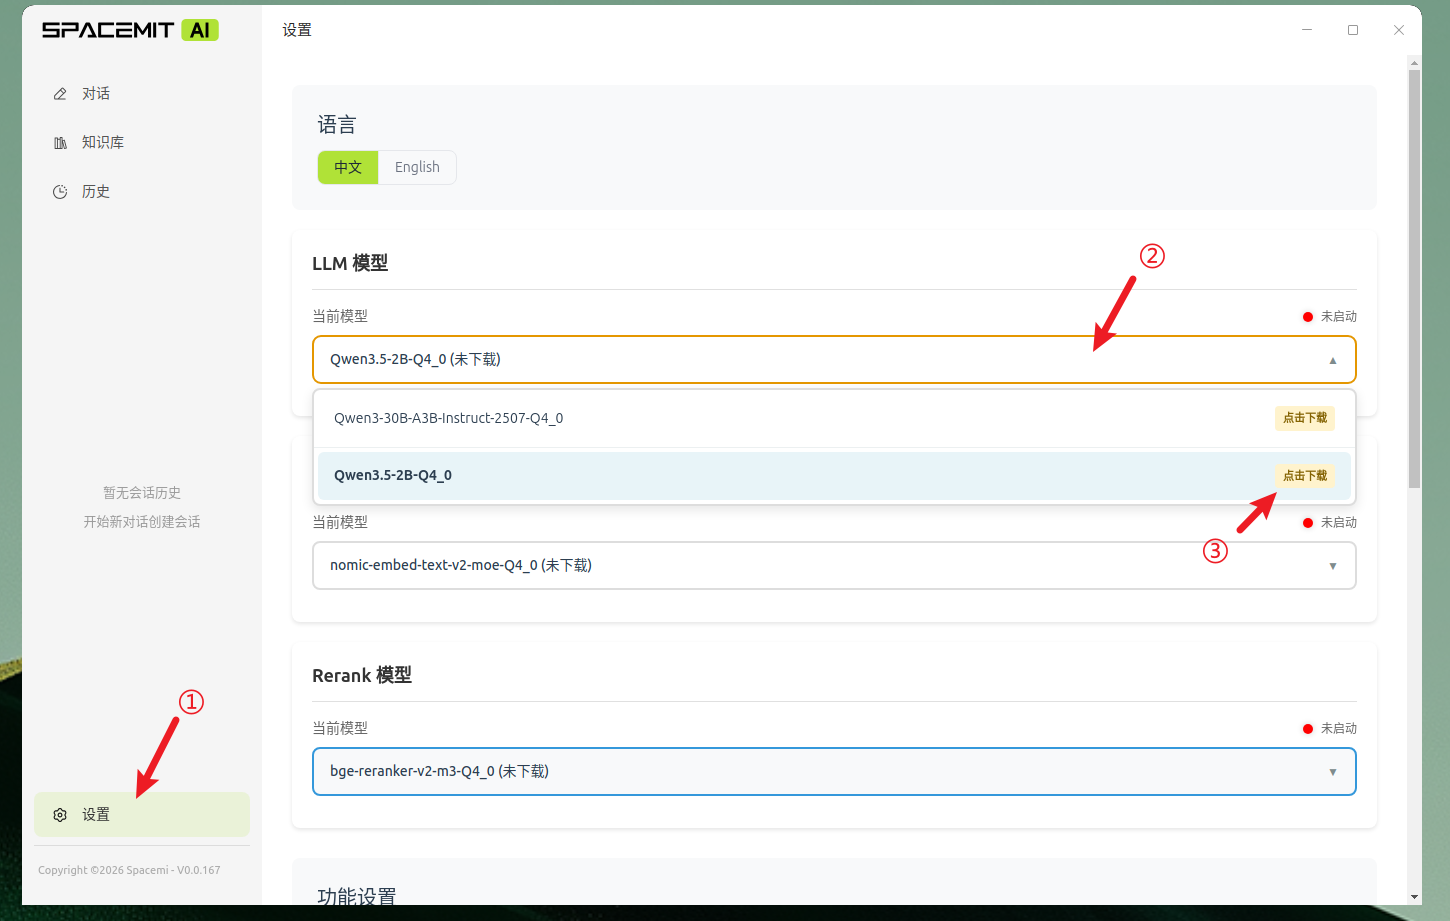
2. 下载模型
首次使用需要下载 AI 模型:
- 点击左侧导航栏的设置图标
- 在模型列表中选择需要的模型
- 点击模型名称开始下载
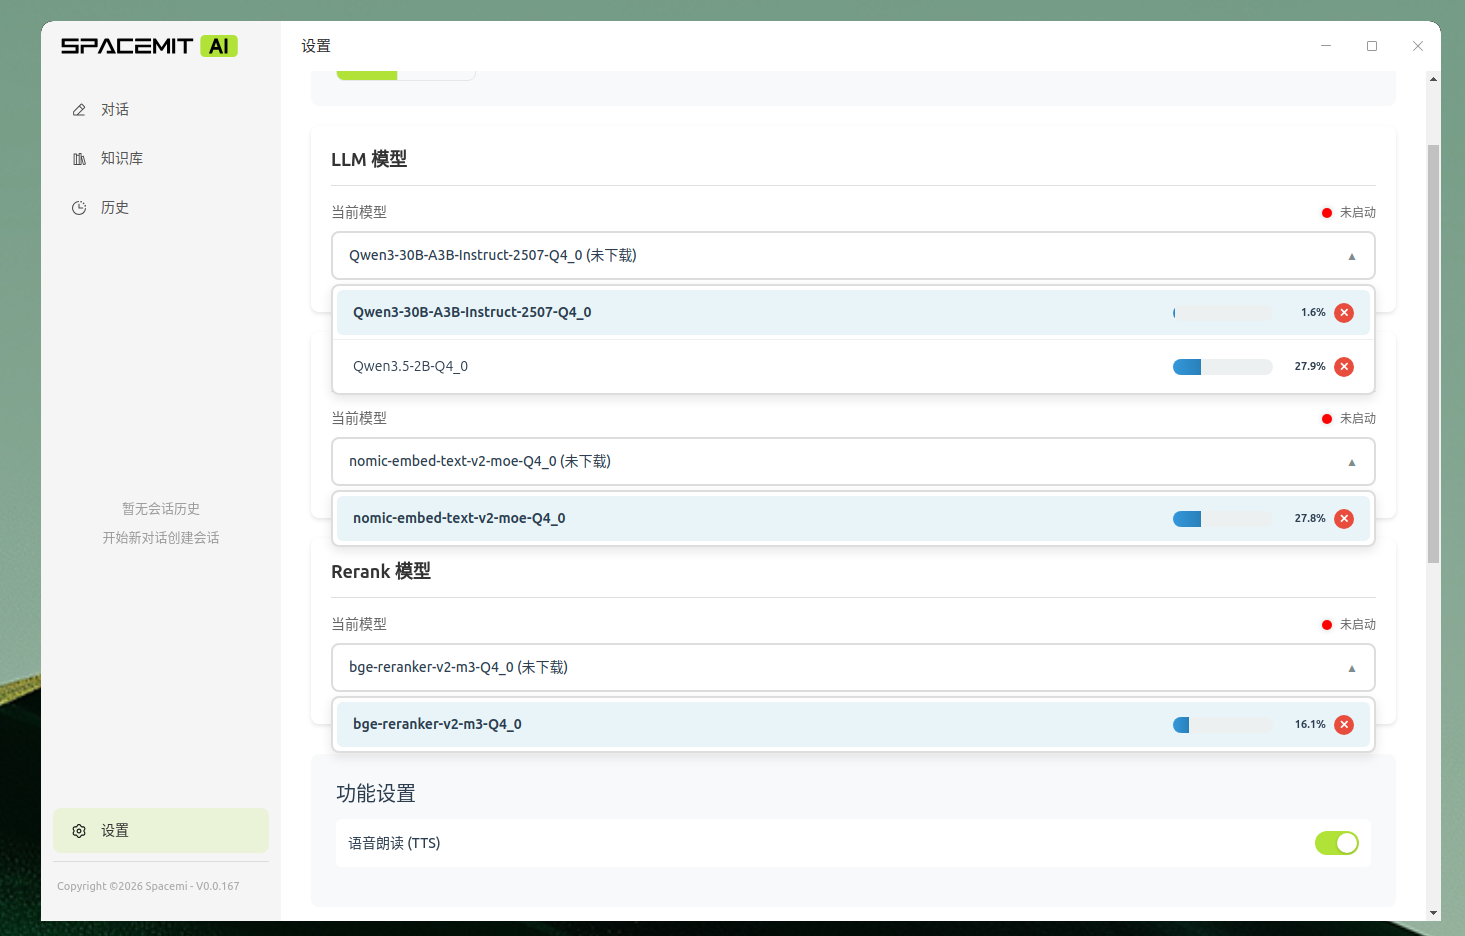
支持同时下载多个模型:
3. 启动模型
下载完成后,再次点击模型名称启动:
- 红灯:模型未启动
- 黄灯:模型启动中
- 绿灯:模型已就绪
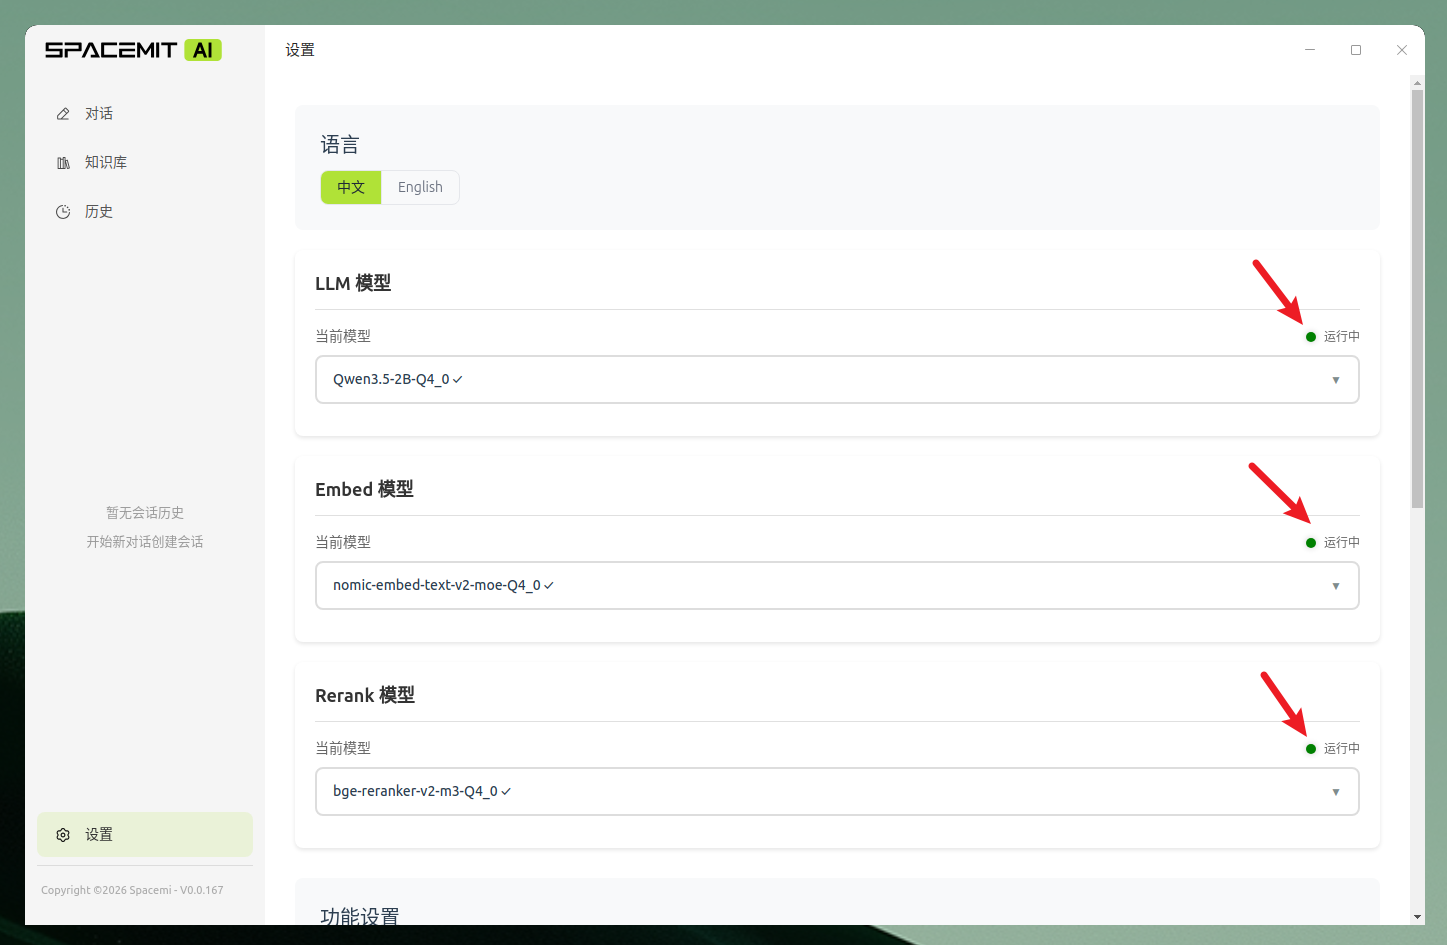
⚠️ 重要提示:为使用完整的知识库功能,建议至少下载并启动以下三类模型各一个:
- LLM 模型:用于对话生成
- Embed 模型:用于文本向量化
- Rerank 模型:用于结果排序
功能使用
智能对话
开始新对话
- 点击左侧导航栏的新对话
- 确认 LLM 模型状态为绿灯
- 在输入框输入问题,按回车或点击发送按钮
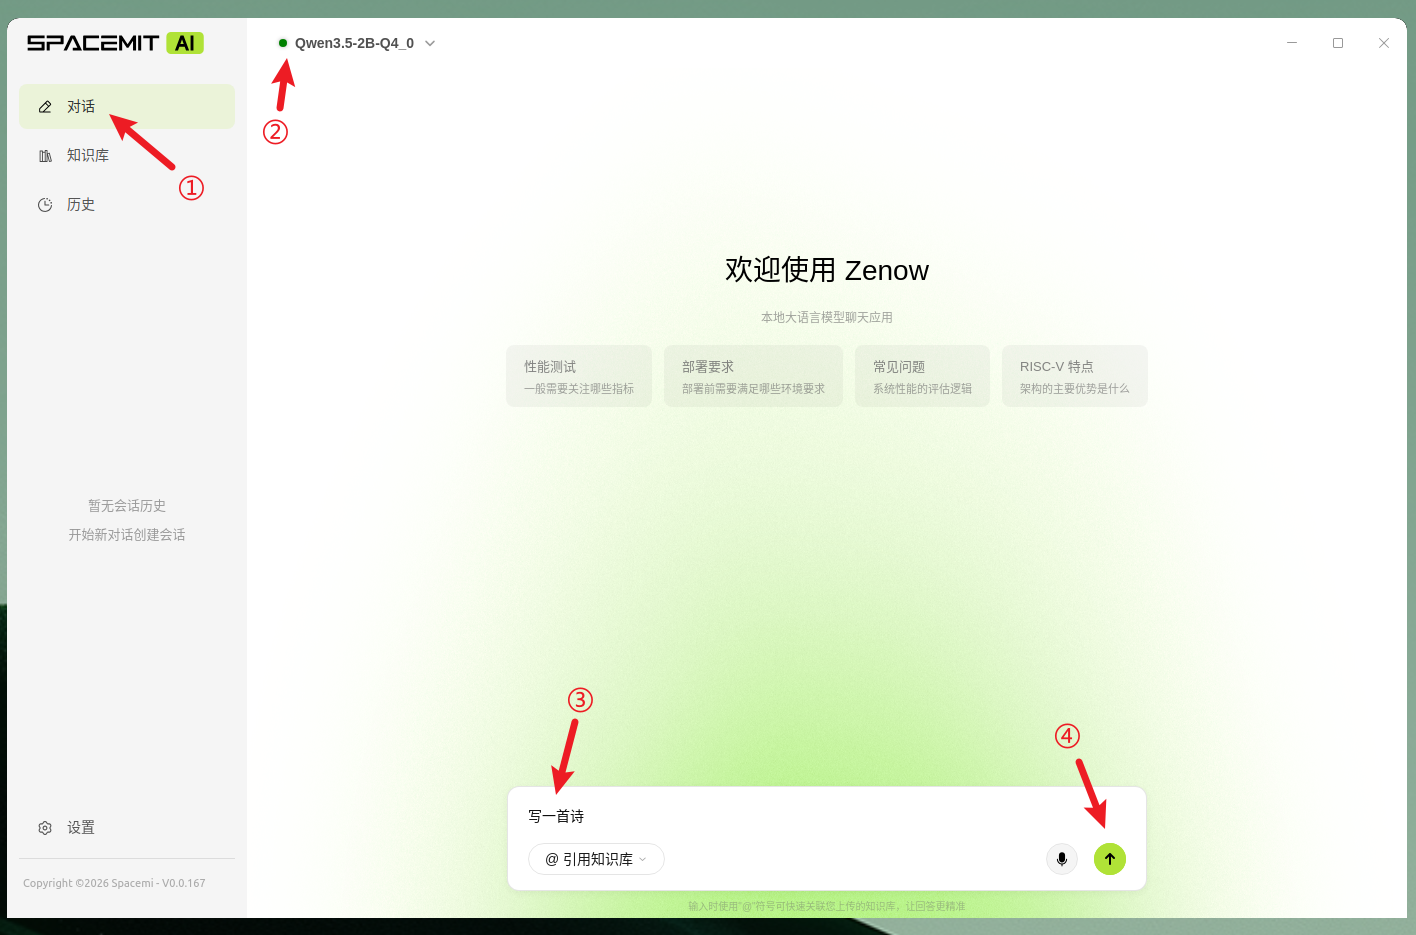
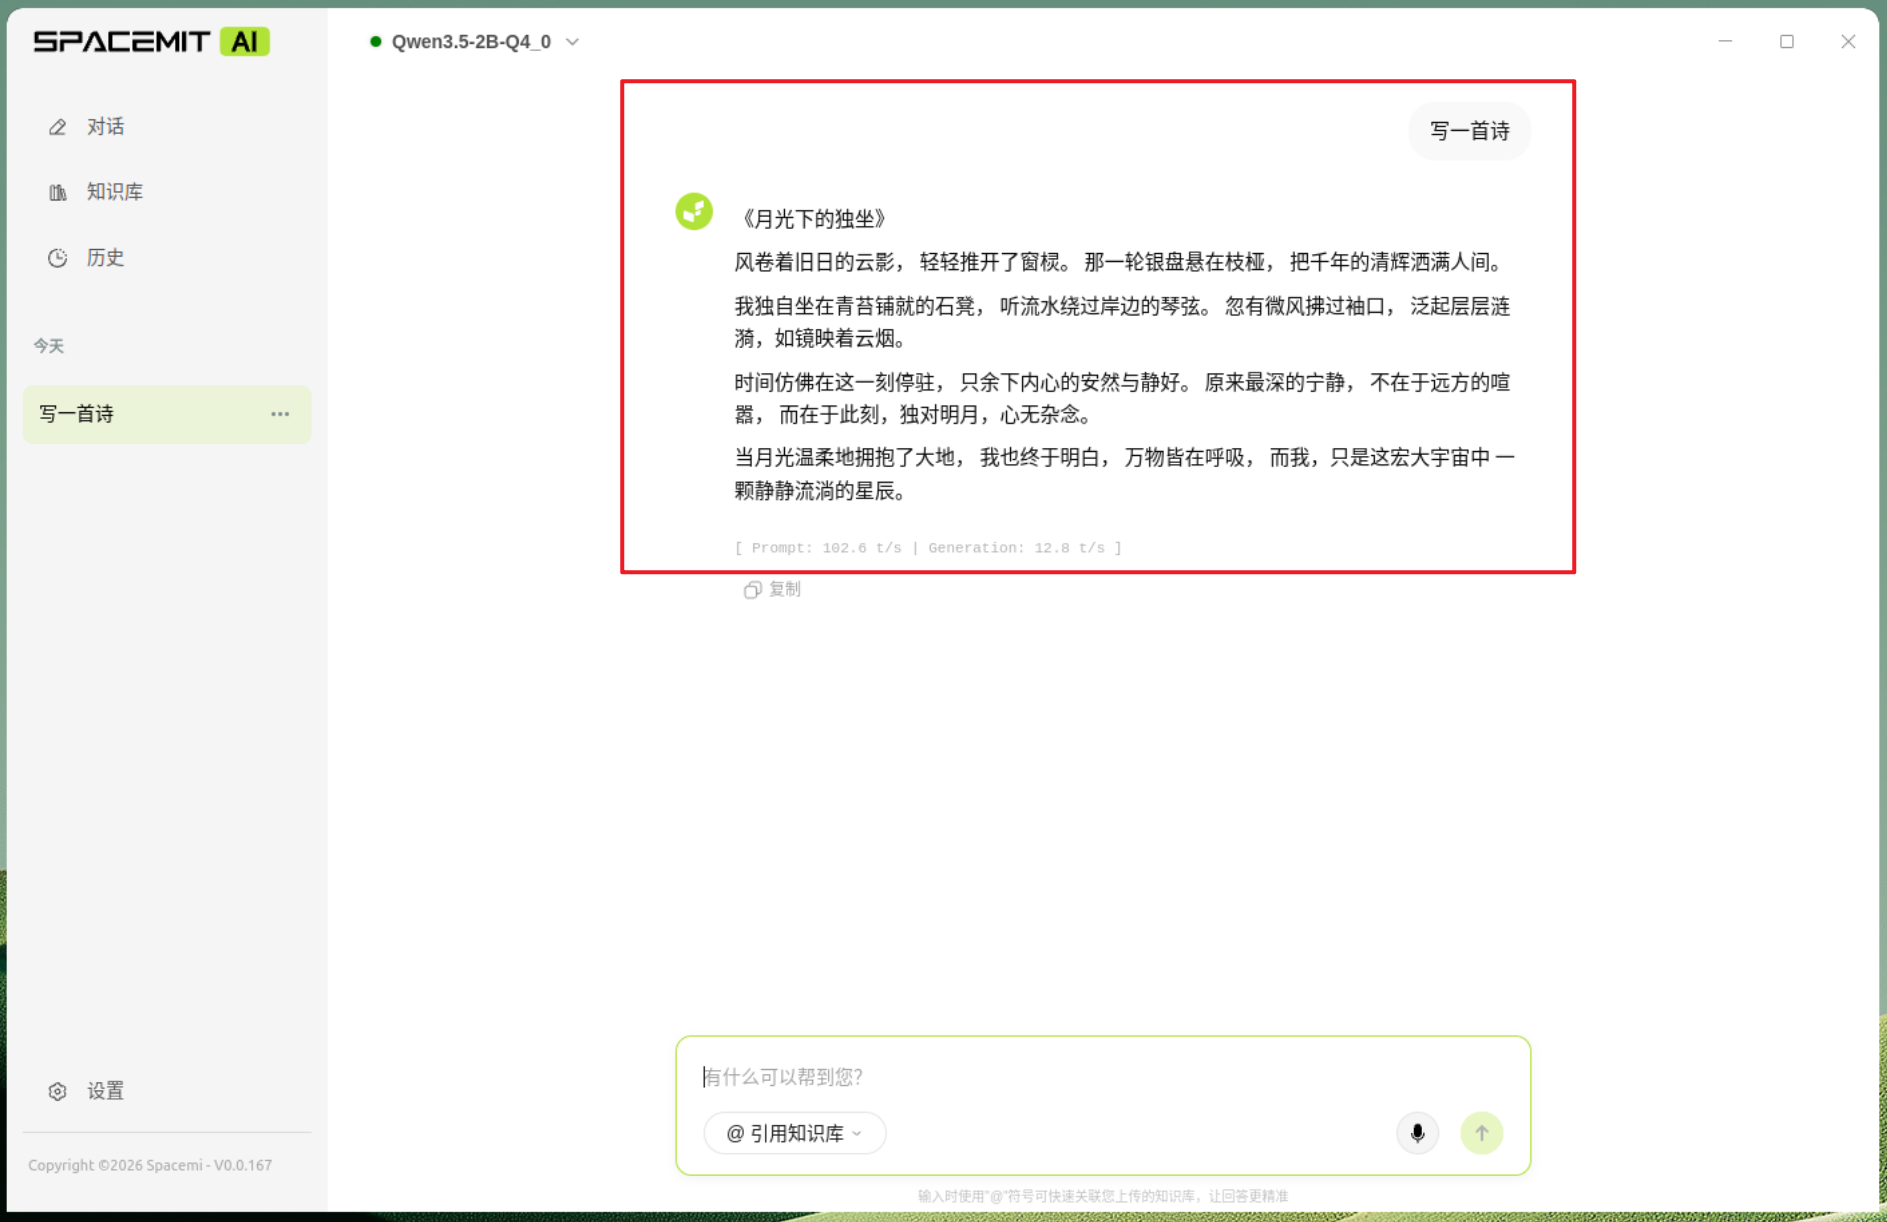
应用会自动创建对话会话,支持多轮连续对话,保持上下文记忆。
知识库管理
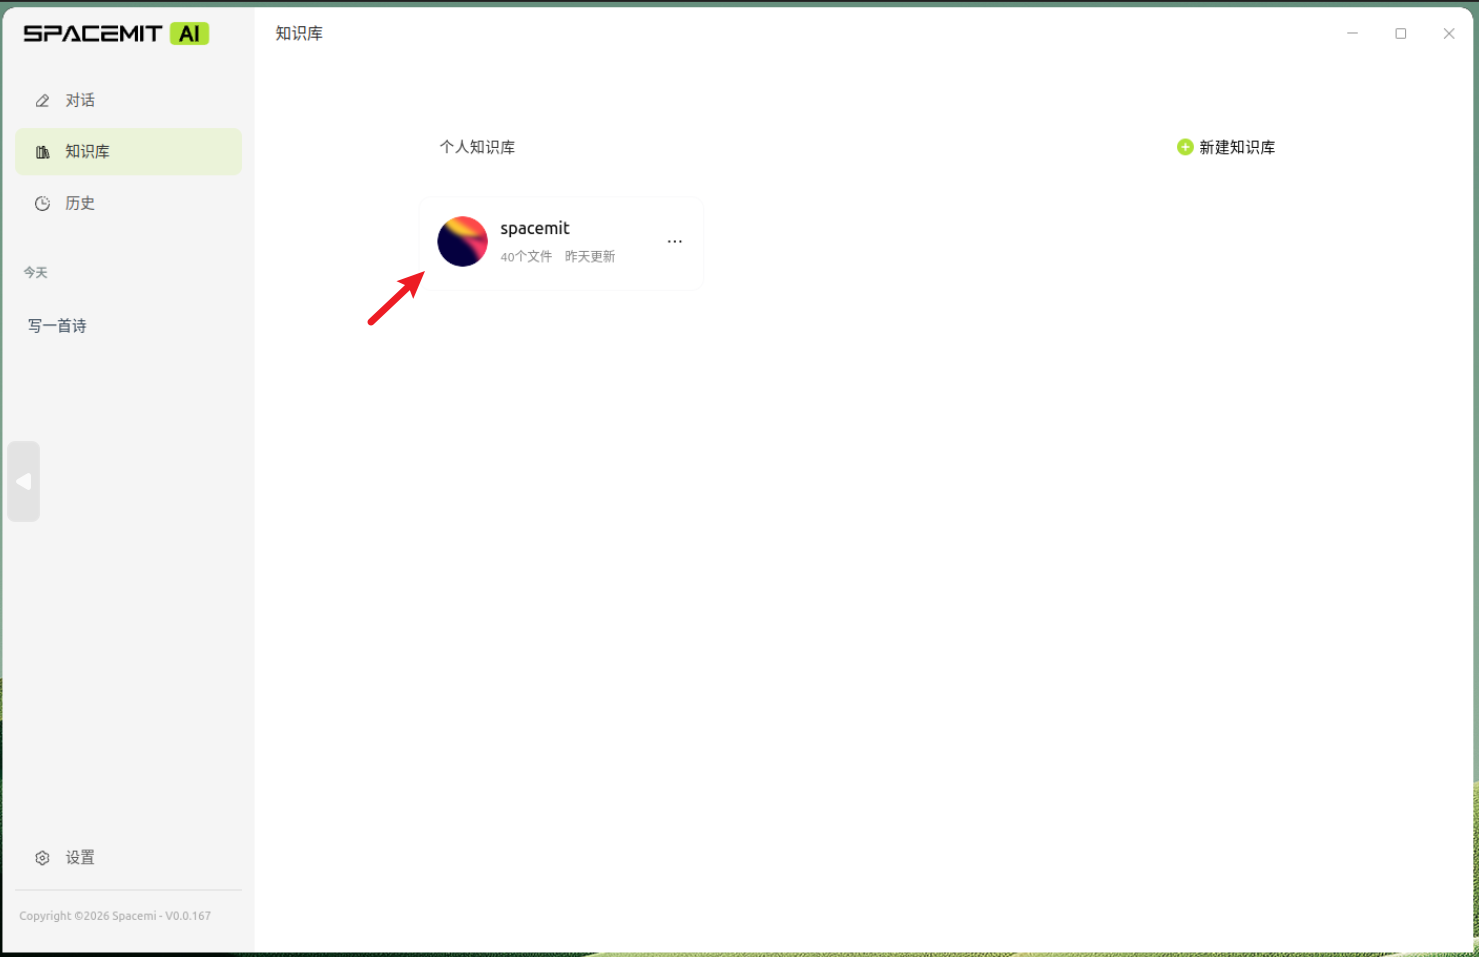
预置知识库
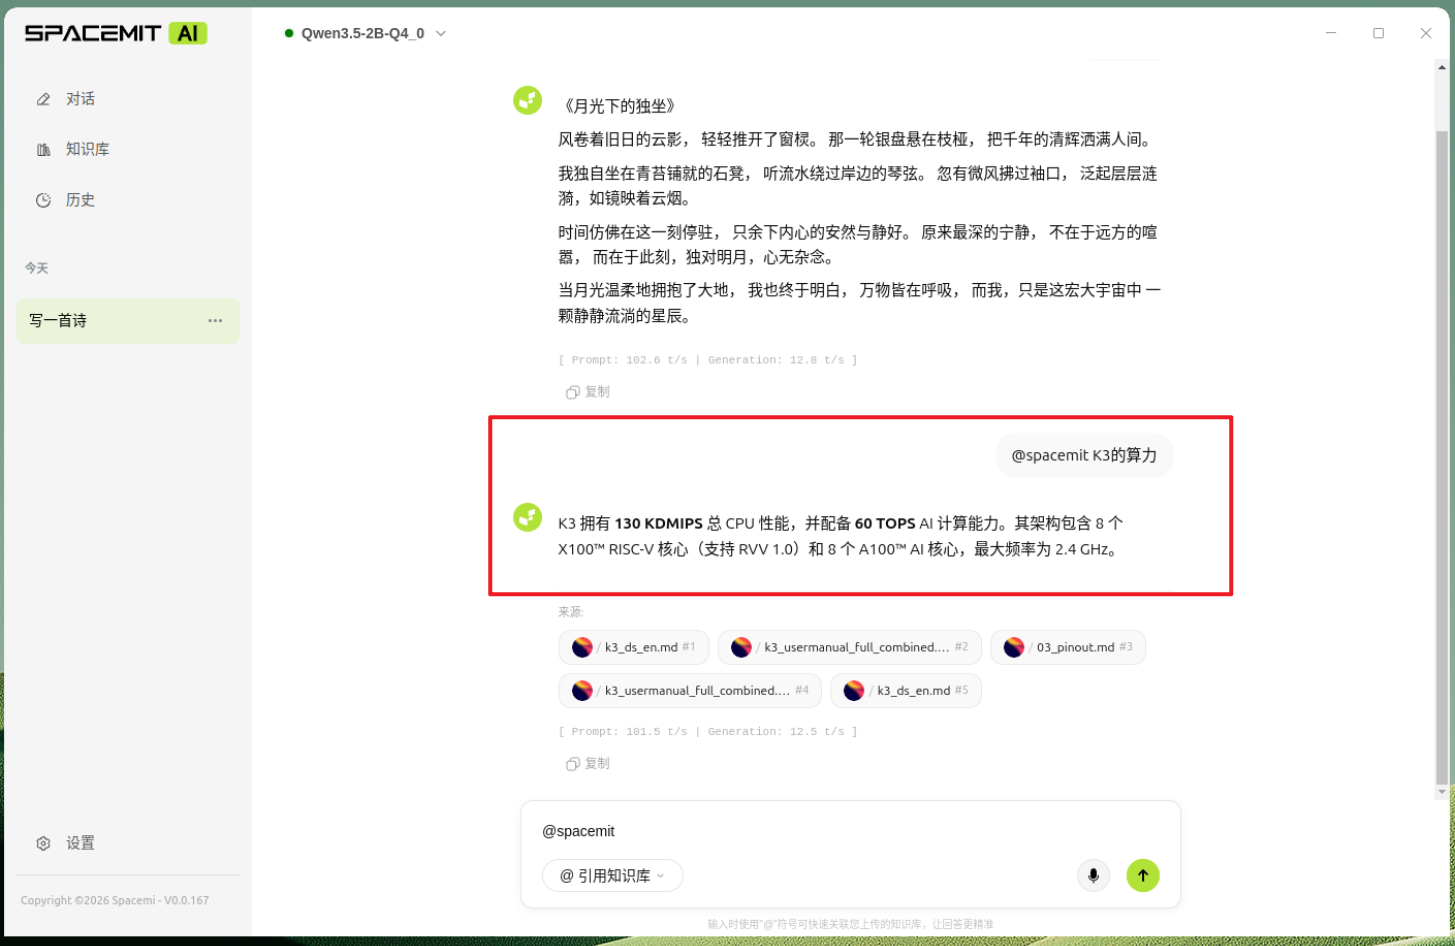
- 知识库默认预置了spacemit知识库,可以用于询问知识库内有的东西的相关问题,如k3的算力
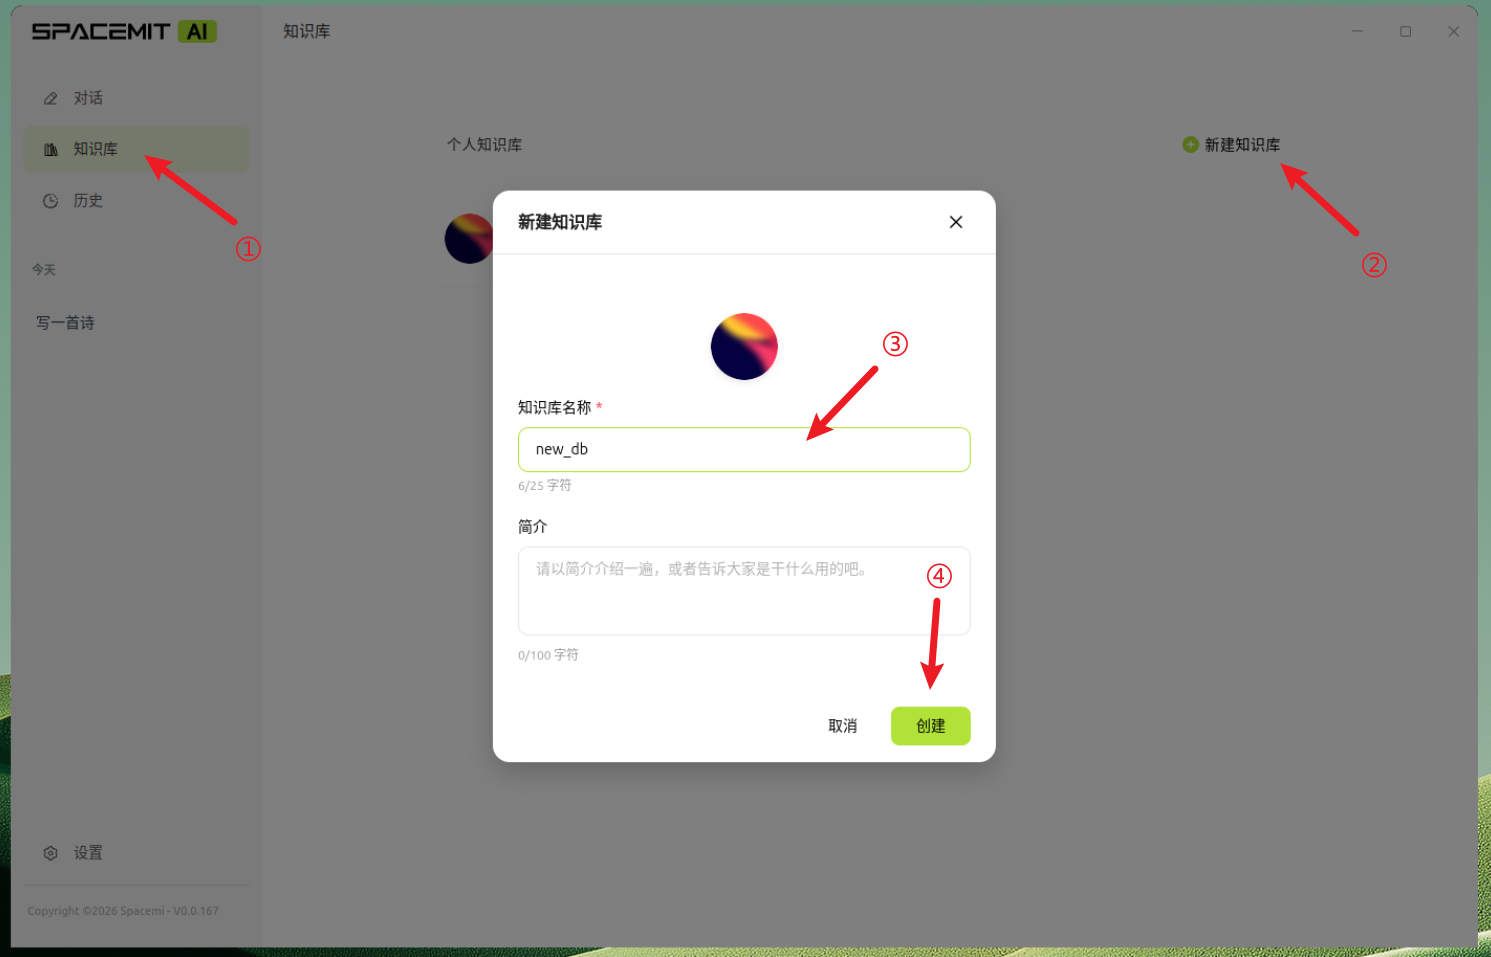
创建知识库
- 点击左侧导航栏的知识库
- 点击新建知识库按钮
- 填写知识库名称和简介
- 可选择自定义头像
导入文档
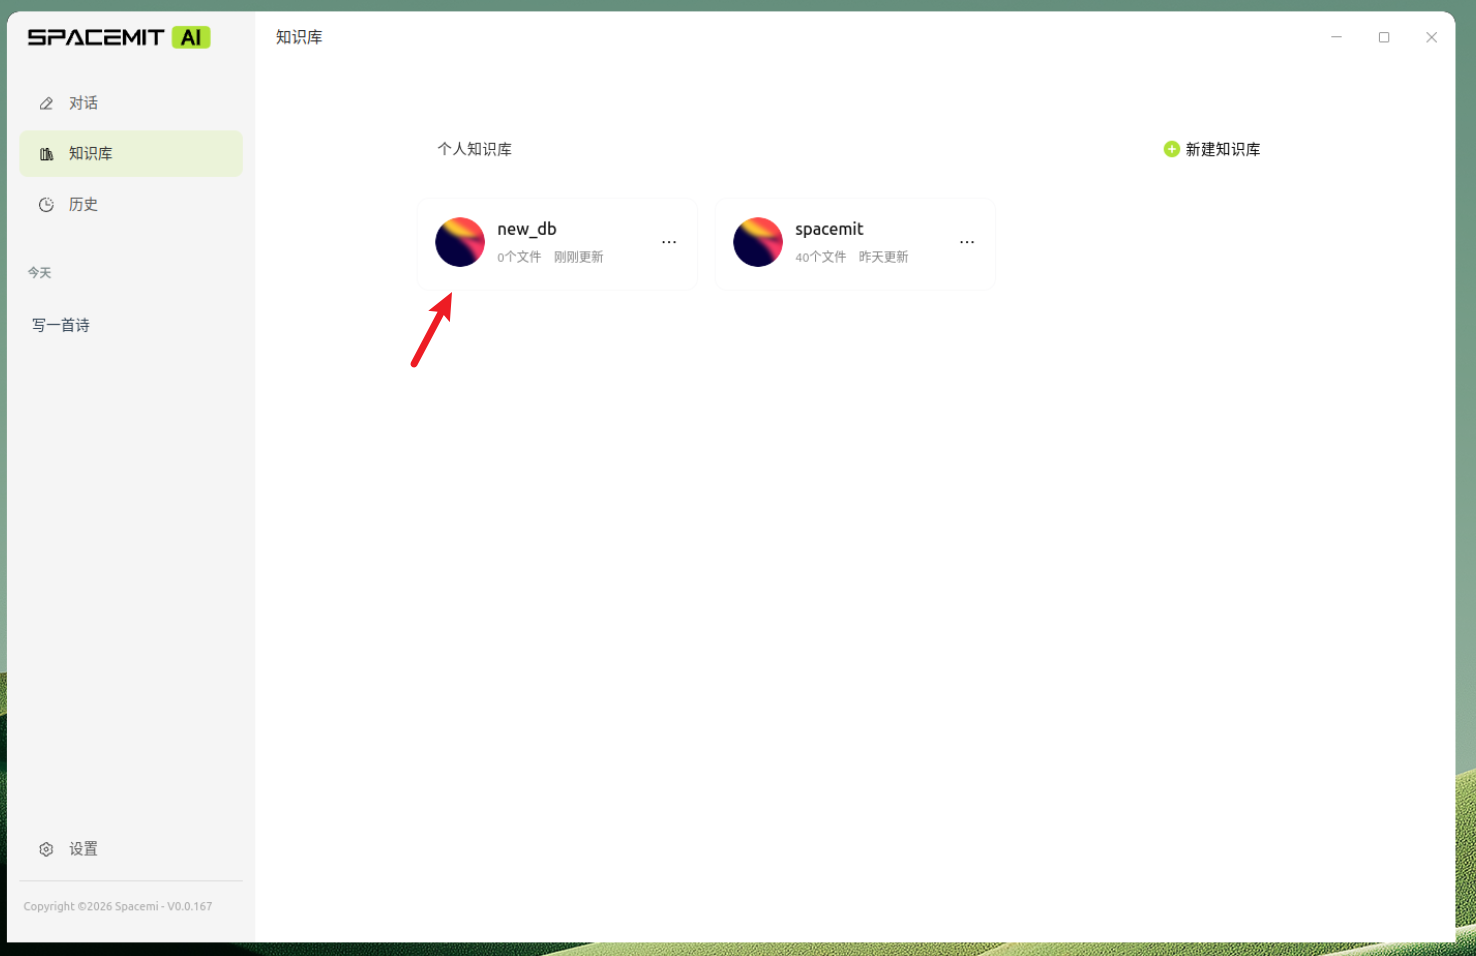
- 进入已创建的知识库
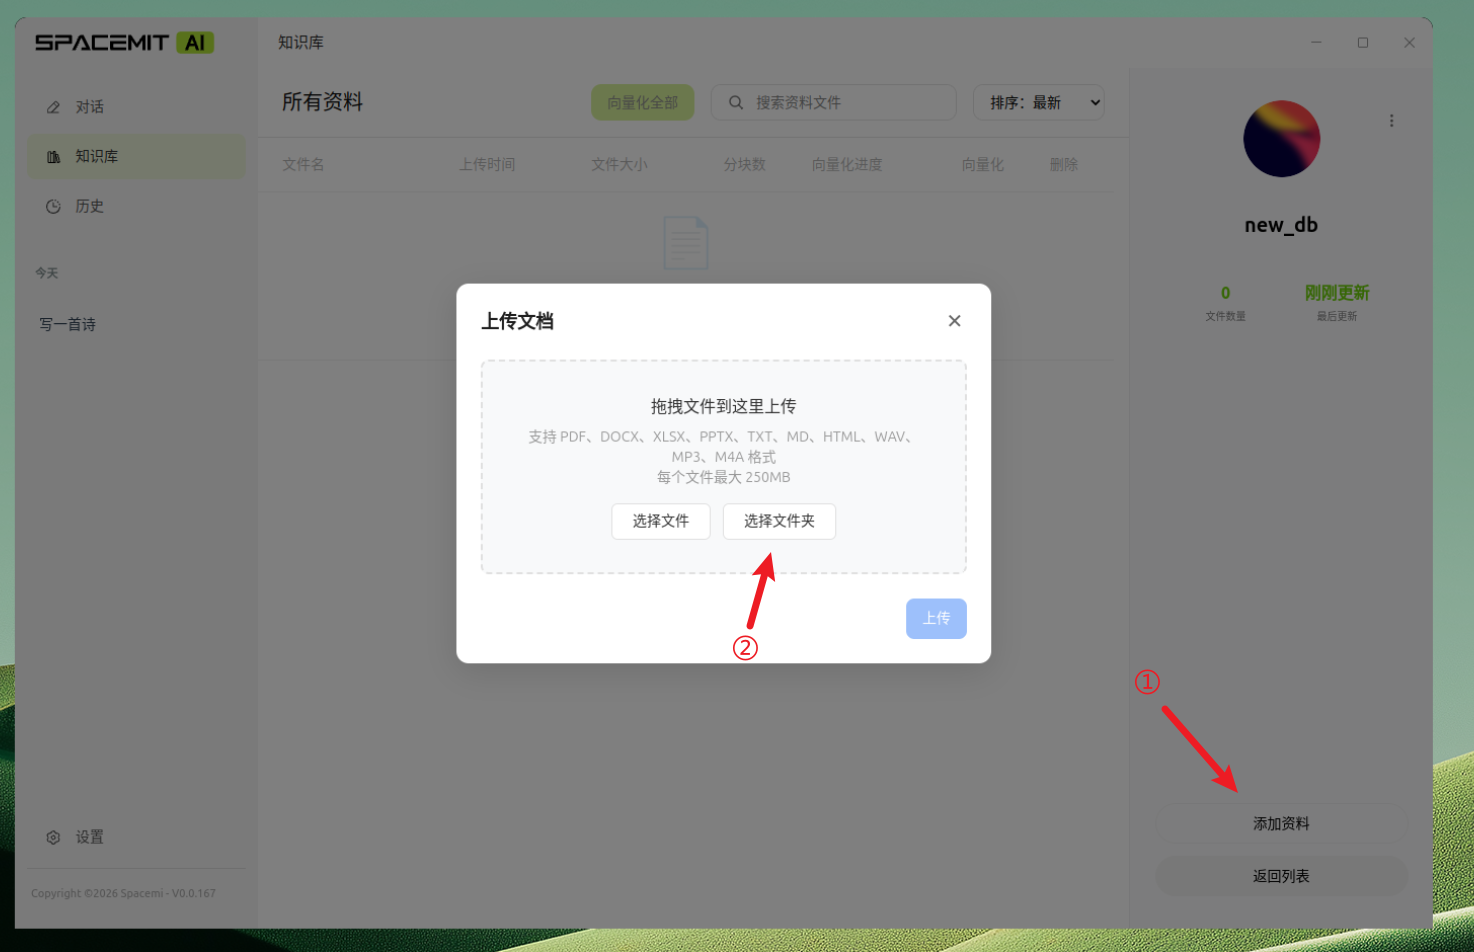
- 点击添加文档按钮
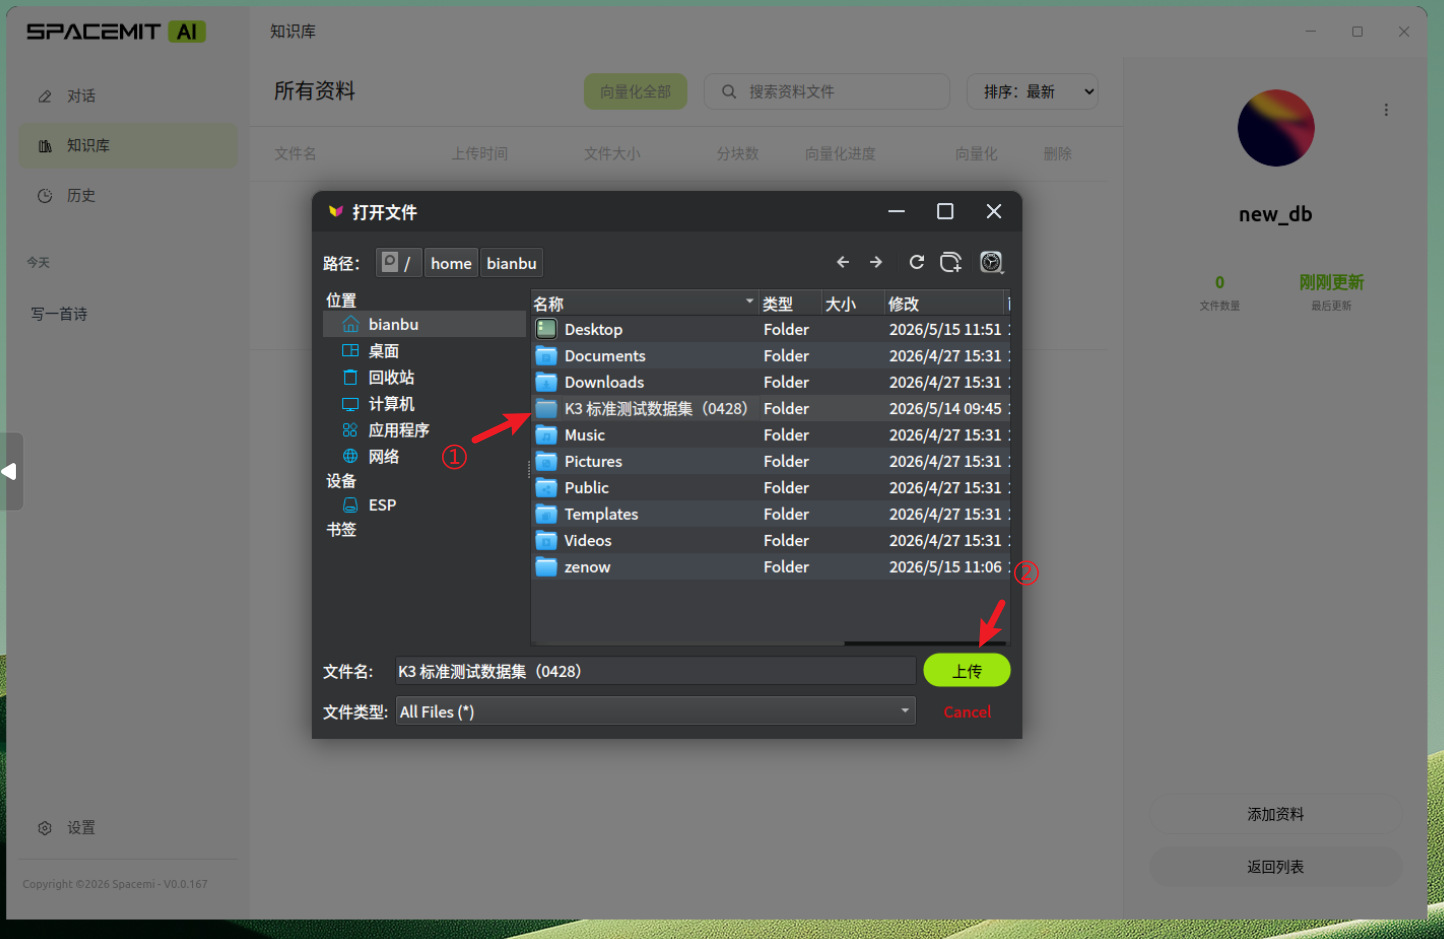
- 选择要上传的文件(支持按住 Ctrl 多选)
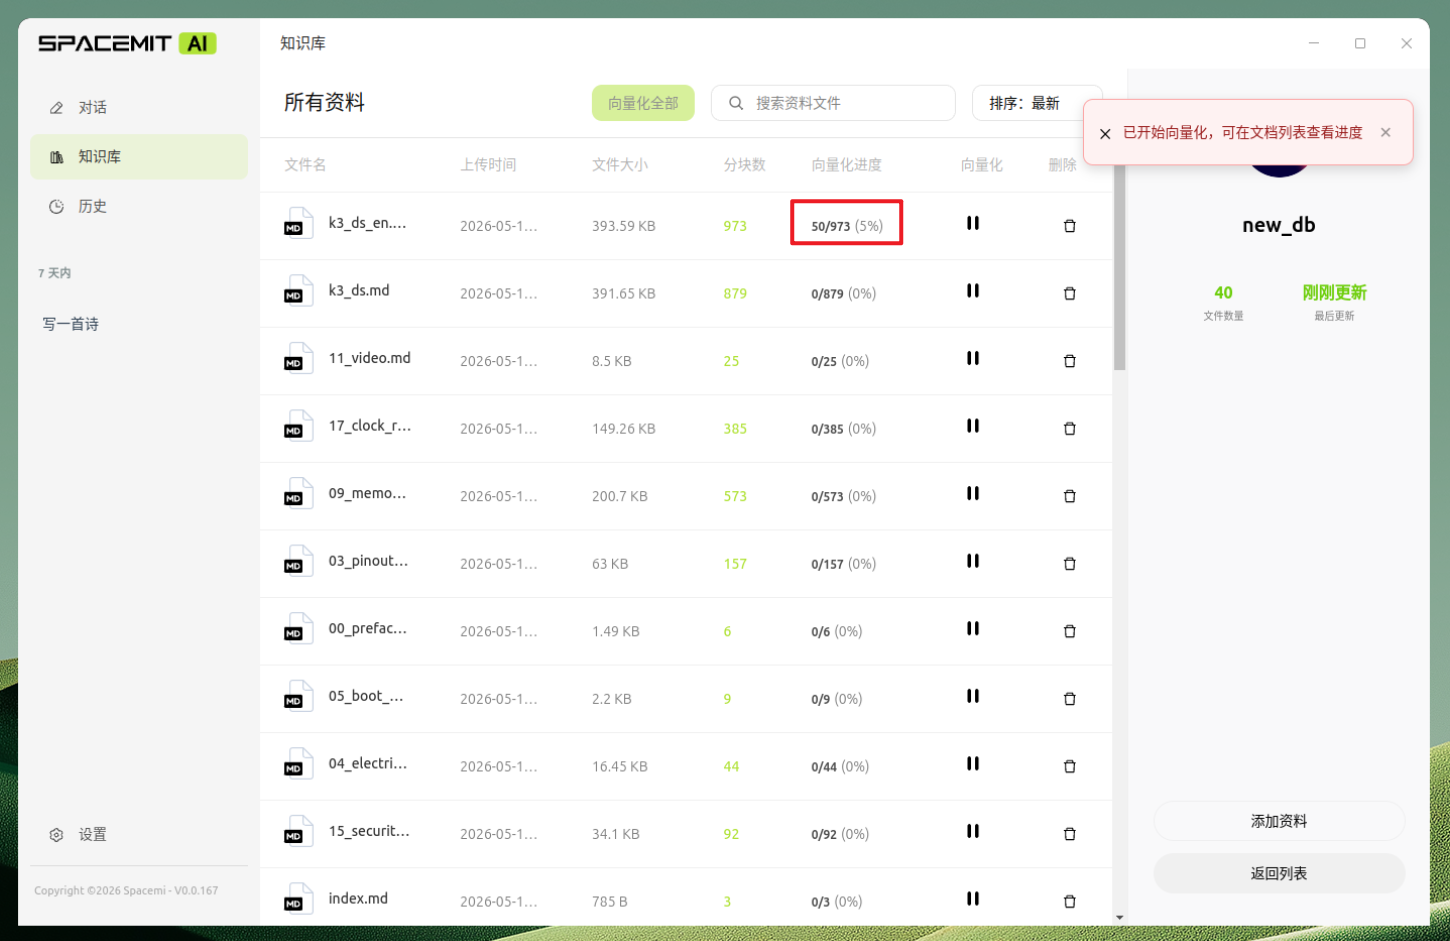
- 等待文档处理完成
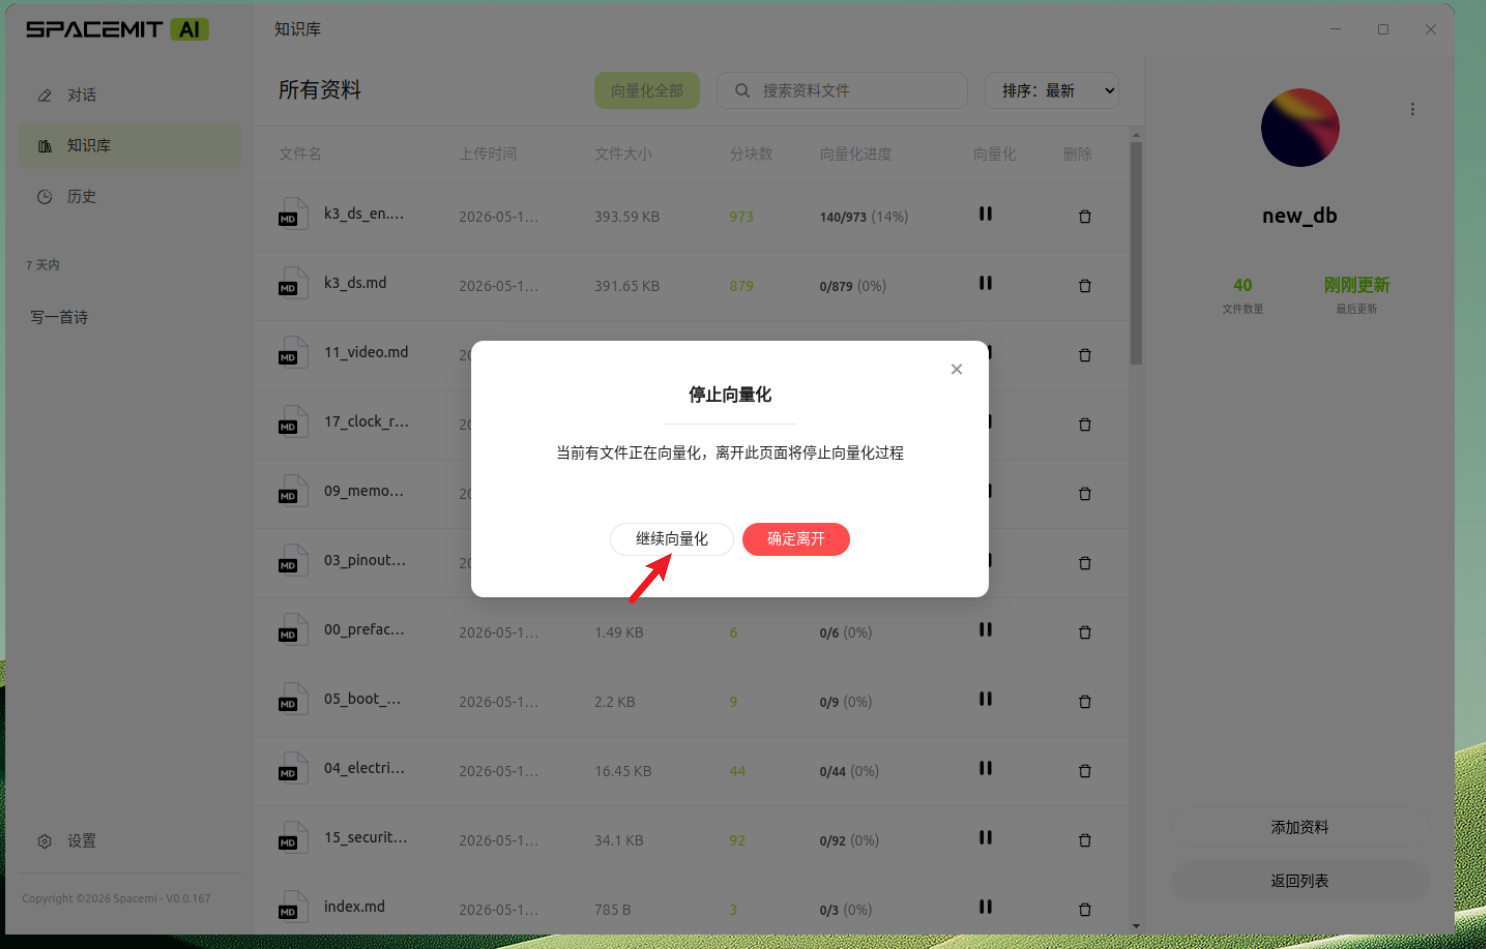
- 如果文档未向量完离开该页面,会有弹窗,此时点击继续向量化耐心等待向量化完成
基于知识库对话
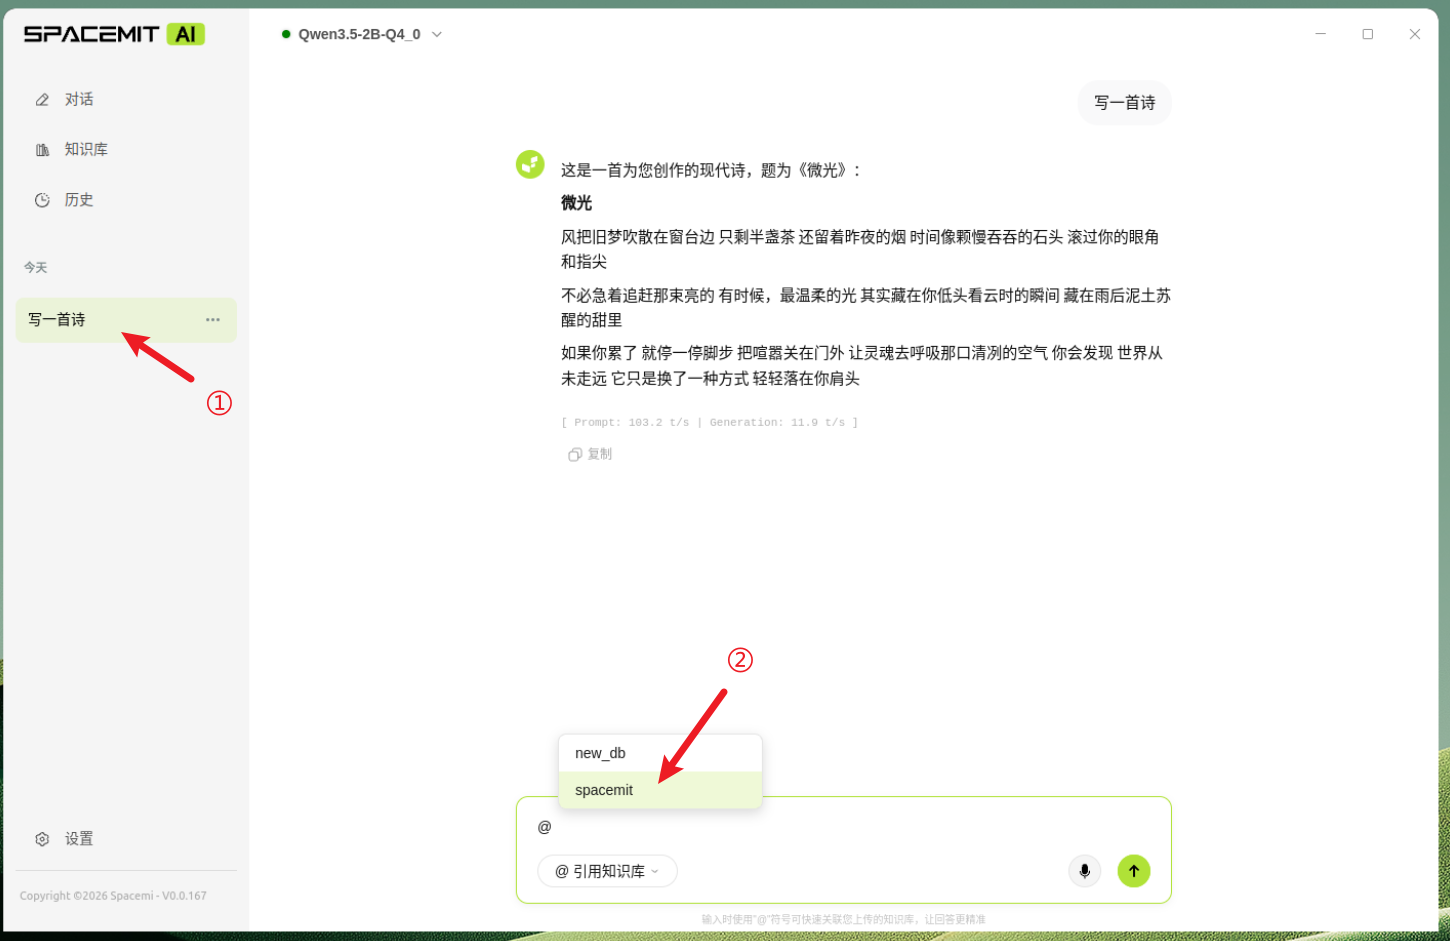
- 选择新建对话或者选择历史会话
- 在输入框中,输入@,接着在选择栏中选择要使用的知识库
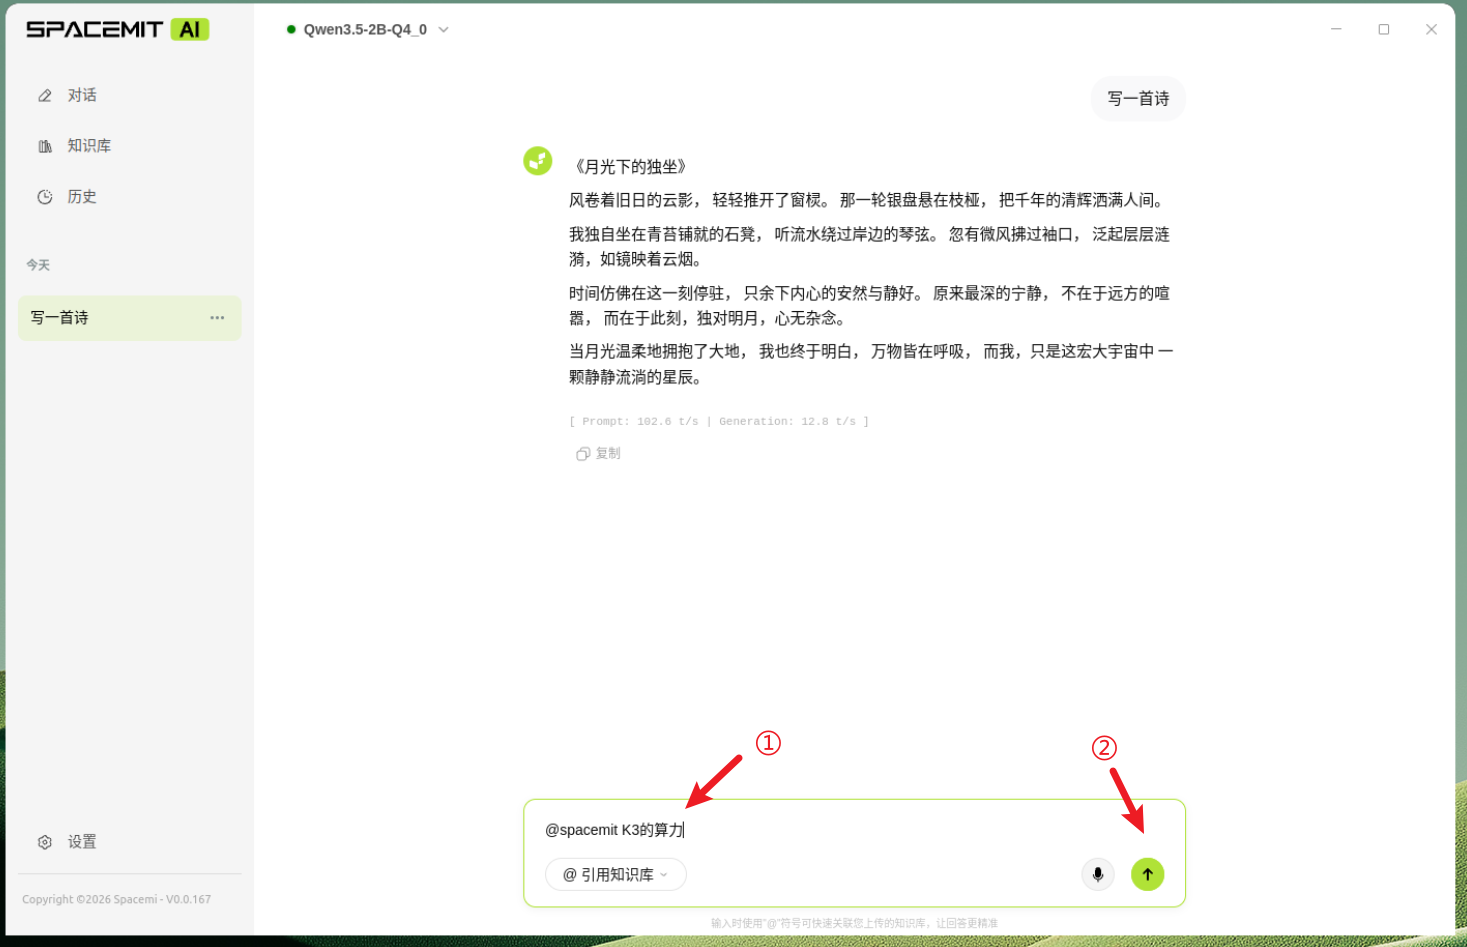
- 输入问题,并按回车,AI 将基于知识库内容回答
高级设置
对话参数
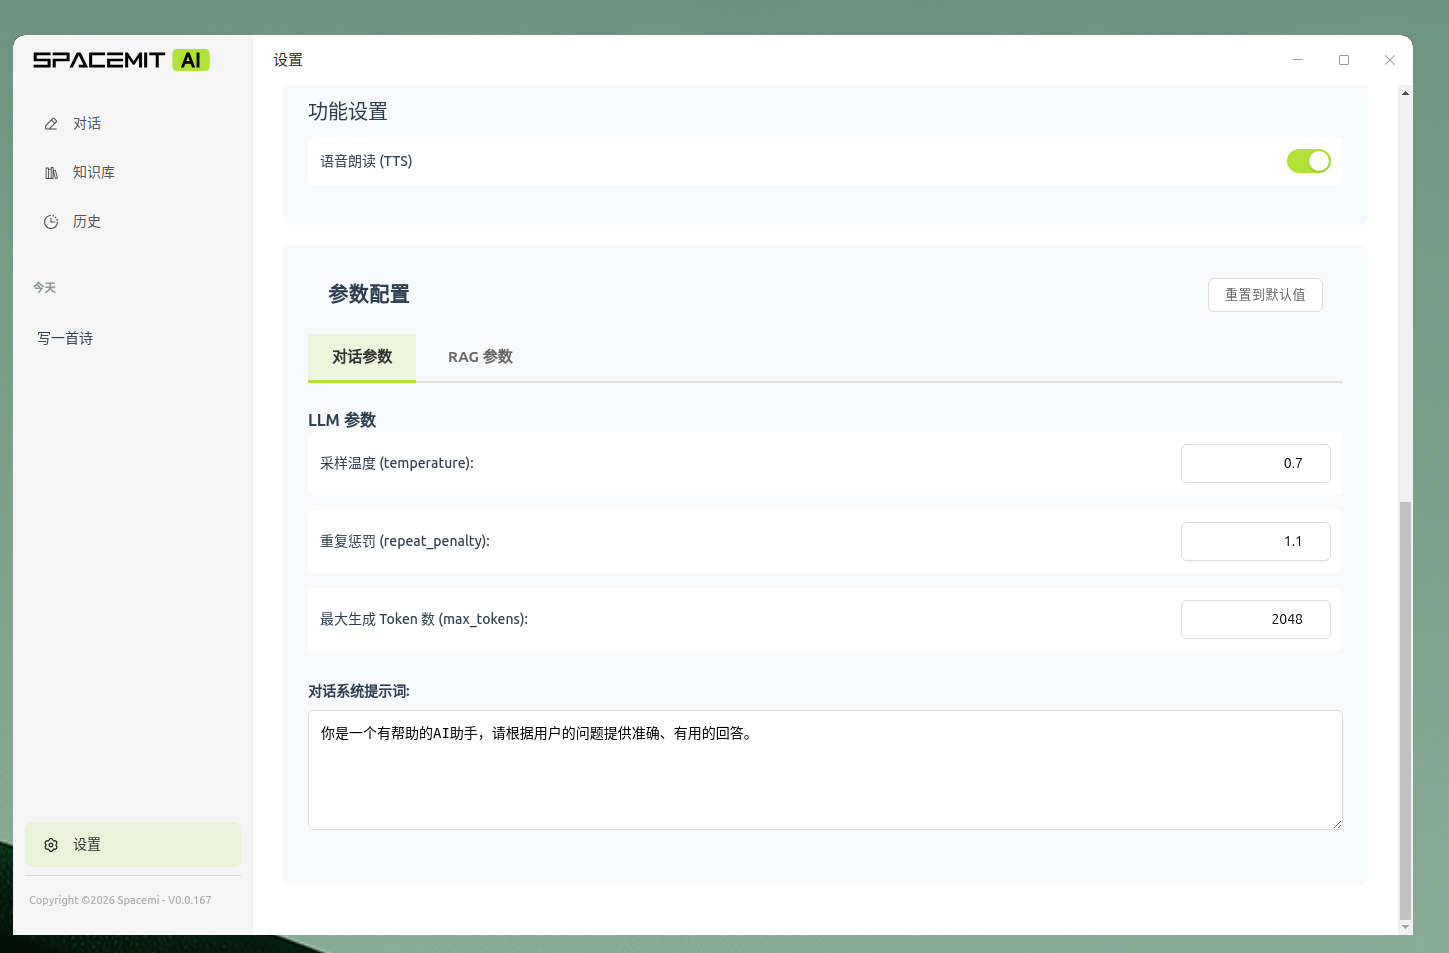
在设置页面可以调整 LLM 模型的生成参数:
LLM 客户端参数
- temperature(温度):控制生成随机性,默认 0.7,范围 0.0-2.0,值越高越随机
- repeat_penalty(重复惩罚):避免重复生成相同内容,默认 1.1
- max_tokens(最大生成长度):单次回复的最大 token 数,默认 2048
对话系统提示词(conversation_system_prompt)
- 定义 AI 的角色、行为和回答风格
- 用于普通对话模式(不使用知识库时)
RAG 参数
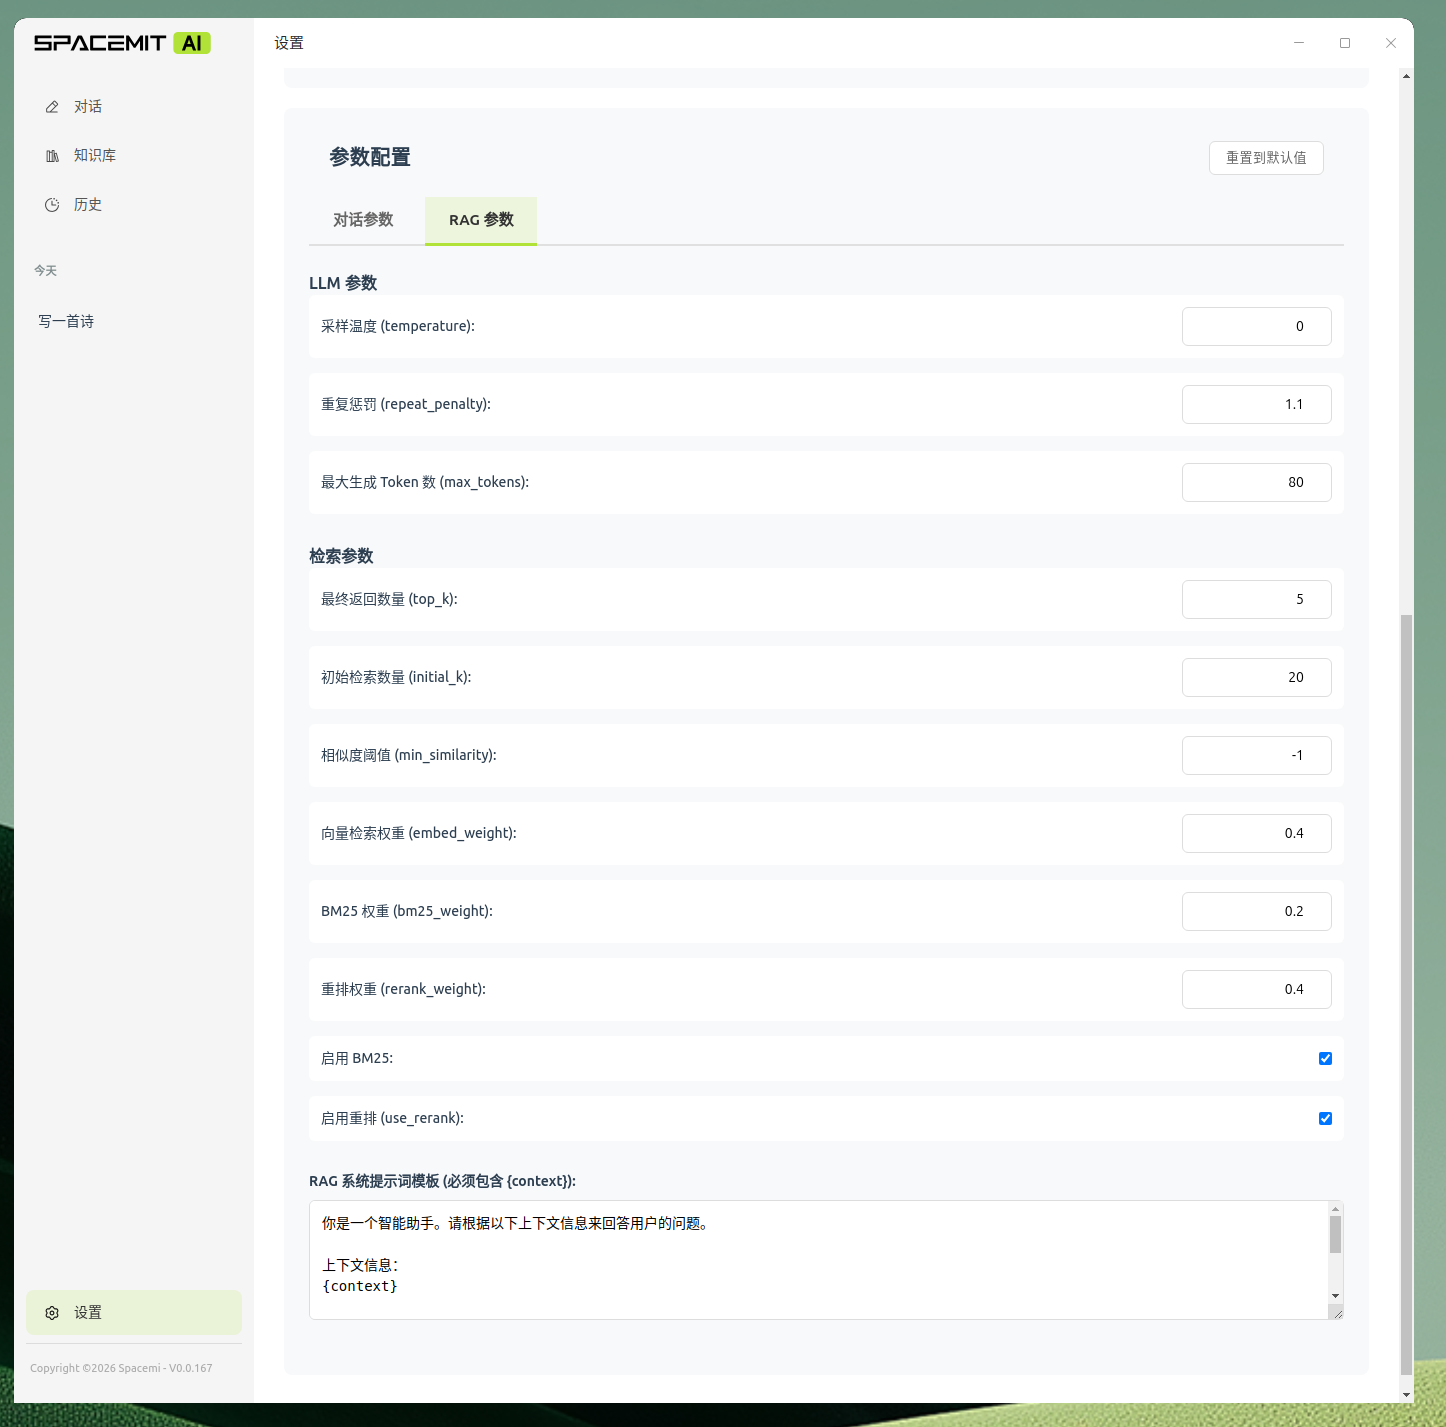
知识库问答使用两阶段检索 + 加权融合策略,可调整以下参数:
LLM 客户端参数(RAG 模式)
- temperature(温度):默认 0(确定性输出)
- repeat_penalty(重复惩罚):默认 1.1
- max_tokens(最大生成长度):默认 120
检索参数(retrieval)
-
top_k(最终返回数量)
- 经过加权融合后,最终返回给 LLM 的文档片段数量
- 默认:5
- 范围:1-20
- 影响上下文长度和生成质量
-
initial_k(初始检索数量)
- 第一阶段 Embed 向量搜索的候选文档数量
- 默认:10
- 范围:5-100
- 值越大召回率越高,但计算成本也越高
-
min_similarity(最小相似度)
- 文档相似度阈值,低于此值的结果会被过滤
- 默认:-1(不过滤)
- 范围:-1.0 到 1.0
融合权重参数
-
embed_weight(向量权重)
- Embed 向量相似度得分在融合中的权重
- 默认:0.4
- 范围:0.0-1.0
- 控制语义相似度的重要性
-
bm25_weight(关键词权重)
- BM25 关键词匹配得分在融合中的权重
- 默认:0.2
- 范围:0.0-1.0
- 控制精确关键词匹配的重要性
-
rerank_weight(重排序权重)
- Rerank 模型得分在融合中的权重
- 默认:0.4
- 范围:0.0-1.0
- 控制深度语义理解的重要性
💡 权重说明:三个权重之和应为 1.0,系统会自动归一化。设置权重为 0 可跳过对应的检索器。
开关参数
- bm25_enable(启用 BM25):是否启用 BM25 关键词检索,默认 true
- rerank_enable(启用 Rerank):是否启用 Rerank 重排序,默认 true
检索流程说明
-
阶段一:Embed 初始过滤
- 使用 Embed 模型进行向量相似度搜索
- 检索
initial_k个候选文档块
-
阶段二:加权融合
- Embed 得分:基于余弦相似度计算语义相关性
- BM25 得分:使用预处理的 jieba 分词结果进行关键词匹配(如启用)
- Rerank 得分:使用 Rerank 模型进行深度语义理解(如启用)
- 融合公式:
final_score = embed_weight × embed_score + bm25_weight × bm25_score + rerank_weight × rerank_score
-
阶段三:最终输出
- 按融合得分排序
- 过滤低于
min_similarity的结果 - 返回前
top_k个结果给 LLM - 注入到 RAG 系统提示词的
{context}占位符
💡 性能优化提示:
- BM25 使用数据库中预处理的分词结果,无需实时分词
- 可通过调整权重和开关来平衡召回率和精确度
RAG 系统提示词模板(rag_system_prompt_template)
- 用于知识库问答模式
- 必须包含
{context}占位符 - 使用 @知识库 时生效
{context}会被替换为检索到的相关文档内容
常见问题
模型下载失败怎么办?
- 检查网络连接是否正常
- 确认磁盘空间是否充足
- 可以尝试重新下载
模型启动失败显示红灯?
- 检查系统资源是否充足(内存),30B模型最好使用32GB及以上内存
知识库问答效果不好?
- 确保已启动 LLM、Embed、Rerank 三类模型
- 调整 RAG参数
- 检查上传的文档内容是否相关
如何提升响应速度?
- 选择较小的模型(如 2B 而非 30B)
- 减少上下文窗口大小